Hugging Face

2周前发布 18 0 0

一个专注于开源机器学习的平台

收录时间:
2026-09-07
Hugging FaceHugging Face

Hugging Face 是什么

Hugging Face 是一个专注于开源机器学习的平台,提供了一系列强大的工具和资源,帮助开发者和研究人员完成 AI 模型的开发、训练、部署与共享。它因强大的 Transformer 模型库与易用的 API 闻名,广泛应用于自然语言处理(NLP)领域,甚至被视作“AI 模型界的 GitHub”,核心目标是降低 AI 模型的使用与开发门槛,让更多人便捷地参与 AI 应用构建。
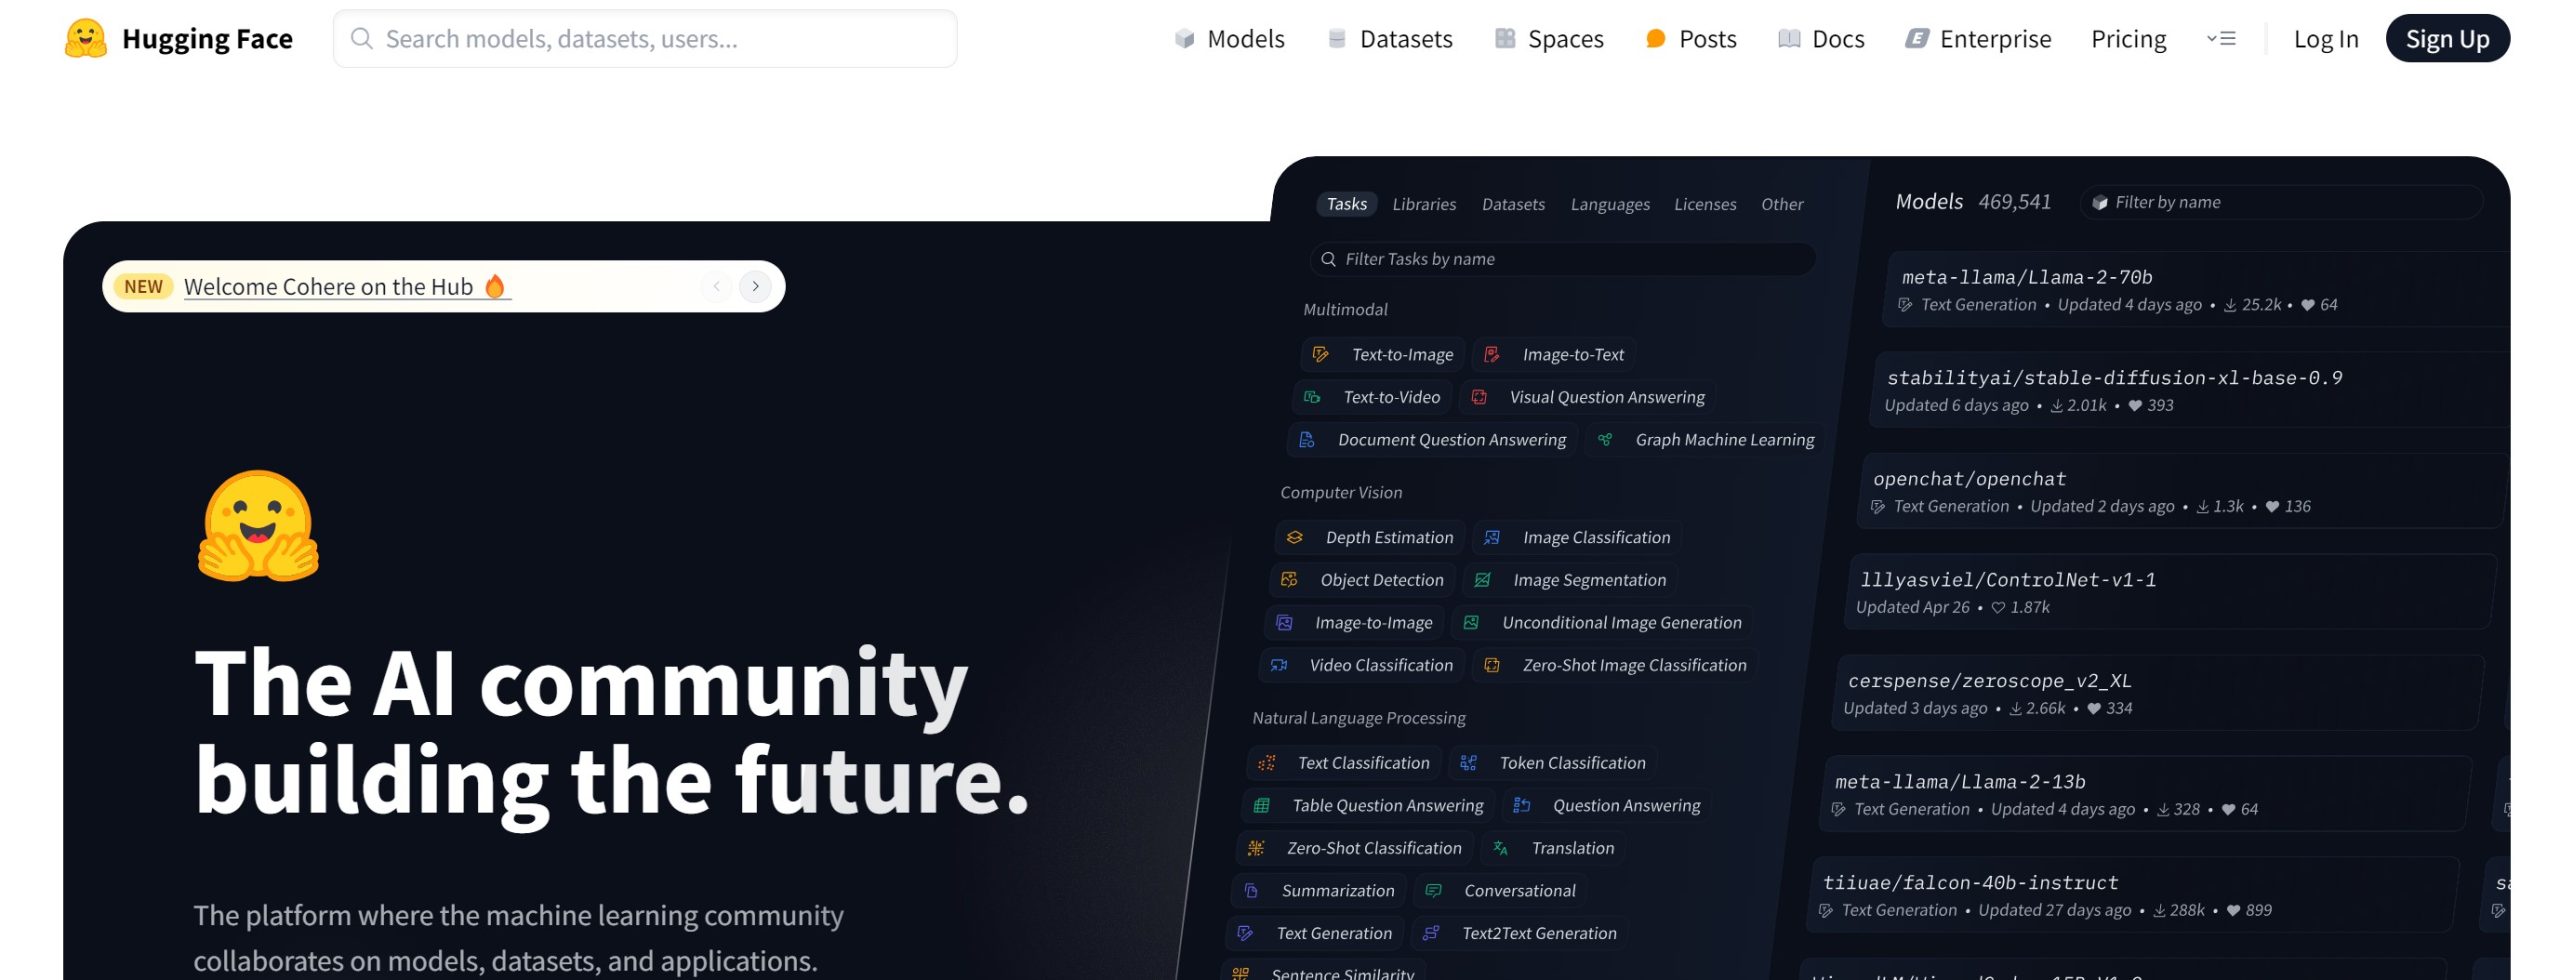
Hugging Face平台界面

Hugging Face 的主要功能

  • 丰富的预训练模型库:Hugging Face 提供超过 50,000 个预训练模型,涵盖 BERT、GPT、T5、RoBERTa 等主流模型,支持文本分类、生成、问答、翻译等多种 AI 任务。
  • 完备的开发工具链
    • Transformers:支持多类预训练模型的开发与部署,提供灵活接口,方便模型微调与自定义开发;
    • Datasets:用于加载和处理 Hugging Face Hub 上的数据集及本地自定义数据集;
    • Tokenizers:将文本转换为模型可处理的数字形式(token id 序列),保障模型输入的标准化;
    • Gradio:帮助开发者快速构建并分享 AI 模型的可视化交互界面,降低演示门槛。
  • 模型与数据集托管共享:通过 Hugging Face Hub 这一集中化平台,开发者可托管、分享自己的模型与数据集,也能快速获取社区资源,方便协作开发机器学习应用。
  • 高效参数微调工具:内置 PEFT 等专项工具,针对大语言模型实现参数高效微调,显著降低训练过程中的资源消耗,提升开发效率。
  • 多模态任务支持:结合自然语言处理与计算机视觉领域能力(如 CLIP、Vision Transformer),可覆盖多模态任务需求,支撑更丰富的 AI 应用场景。

Hugging Face 的使用步骤

  • 注册 Hugging Face 账号:访问 Hugging Face 官网(https://huggingface.co/),点击右上角的 “Sign Up” 按钮,按提示完成账号注册。
  • 安装核心依赖库:通过命令行执行以下指令,安装 Hugging Face 核心工具库:
    pip install transformers datasets tokenizers

    其中,transformers 库负责加载、使用、微调预训练模型;datasets 库用于数据集加载与处理;tokenizers 库完成文本分词,保障模型输入格式规范。

  • 加载预训练模型与分词器:借助 Transformers 库中的 AutoModel 和 AutoTokenizer 类,可快速加载所需预训练模型。以 GPT-2 为例,核心代码如下:
    from transformers import AutoModelForCausalLM, AutoTokenizer
    
    model_name = "gpt2"
    model = AutoModelForCausalLM.from_pretrained(model_name)
    tokenizer = AutoTokenizer.from_pretrained(model_name)
  • 启动模型推理:使用加载的模型与分词器,通过 pipeline 可快速构建任务流程,完成文本生成等推理任务。示例代码:
    from transformers import pipeline
    
    generator = pipeline(task="text-generation", model=model, tokenizer=tokenizer)
    output = generator("Hello, I am a language model,", max_length=50)
    print(output)
  • 微调模型适配专项任务:针对特定业务场景,可对预训练模型进行微调。例如,用 IMDb 影评数据集完成情感分析任务,核心代码片段:
    from transformers import AutoModelForSequenceClassification, AutoTokenizer
    from datasets import load_dataset
    
    dataset = load_dataset("imdb")
    model_name = "bert-base-cased"
    model = AutoModelForSequenceClassification.from_pretrained(model_name, num_labels=2)
    tokenizer = AutoTokenizer.from_pretrained(model_name)
    
    inputs = tokenizer(dataset["train"]["text"][:10], padding=True, truncation=True, return_tensors="pt")
    outputs = model(**inputs)
    predictions = outputs.logits.argmax(dim=-1)
  • 部署模型落地应用:将训练完成的模型部署到 Hugging Face Hub 或其他平台,支持团队协作与他人使用,快速实现 AI 能力的业务落地。

Hugging Face 的产品价格

Hugging Face 核心服务采用「免费+付费」模式:免费服务涵盖模型托管、基础推理,用户可免费使用平台上的预训练资源开展开发与部署;付费服务则针对企业级需求,提供专属算力资源、高级技术支持等增值服务,满足企业用户的高性能训练、定制化协作等要求。
Hugging Face 的使用场景

  • 自然语言处理领域:广泛应用于文本分类、情感分析、机器翻译、问答系统等任务,帮助开发者快速构建语言处理类应用,缩短研发周期。
  • 多模态应用开发:结合 NLP 与计算机视觉能力,支持图像描述生成、视频字幕生成等多模态任务,拓展 AI 应用的边界。
  • 音频处理项目:提供语音识别、语音合成相关工具,适配各类音频处理需求,如智能客服语音交互、有声内容生成等。
  • 教育与科研领域:为研究人员提供丰富的预训练模型与公开数据集,加速科研实验进度;为教育工作者提供教学资源与实践平台,助力 AI 技术的教学落地。
  • 企业级 AI 应用:企业可依托 Hugging Face 的模型与服务,快速开发并部署定制化 AI 应用,提升业务流程效率,如智能风控、客户服务优化等场景。

相关导航

暂无评论

您必须登录才能参与评论!
立即登录
none
暂无评论...