# OpenAI Sora:下一代AI视频生成模型的功能与技术详解
作为OpenAI推出的重磅AI视频生成工具,**Sora**凭借其突破性的技术能力,正在重塑AI视频创作的边界。从文本生成到复杂场景构建,Sora的表现远超传统同类工具,引发了全球创作者与技术圈的广泛关注。
什么是OpenAI的Sora?
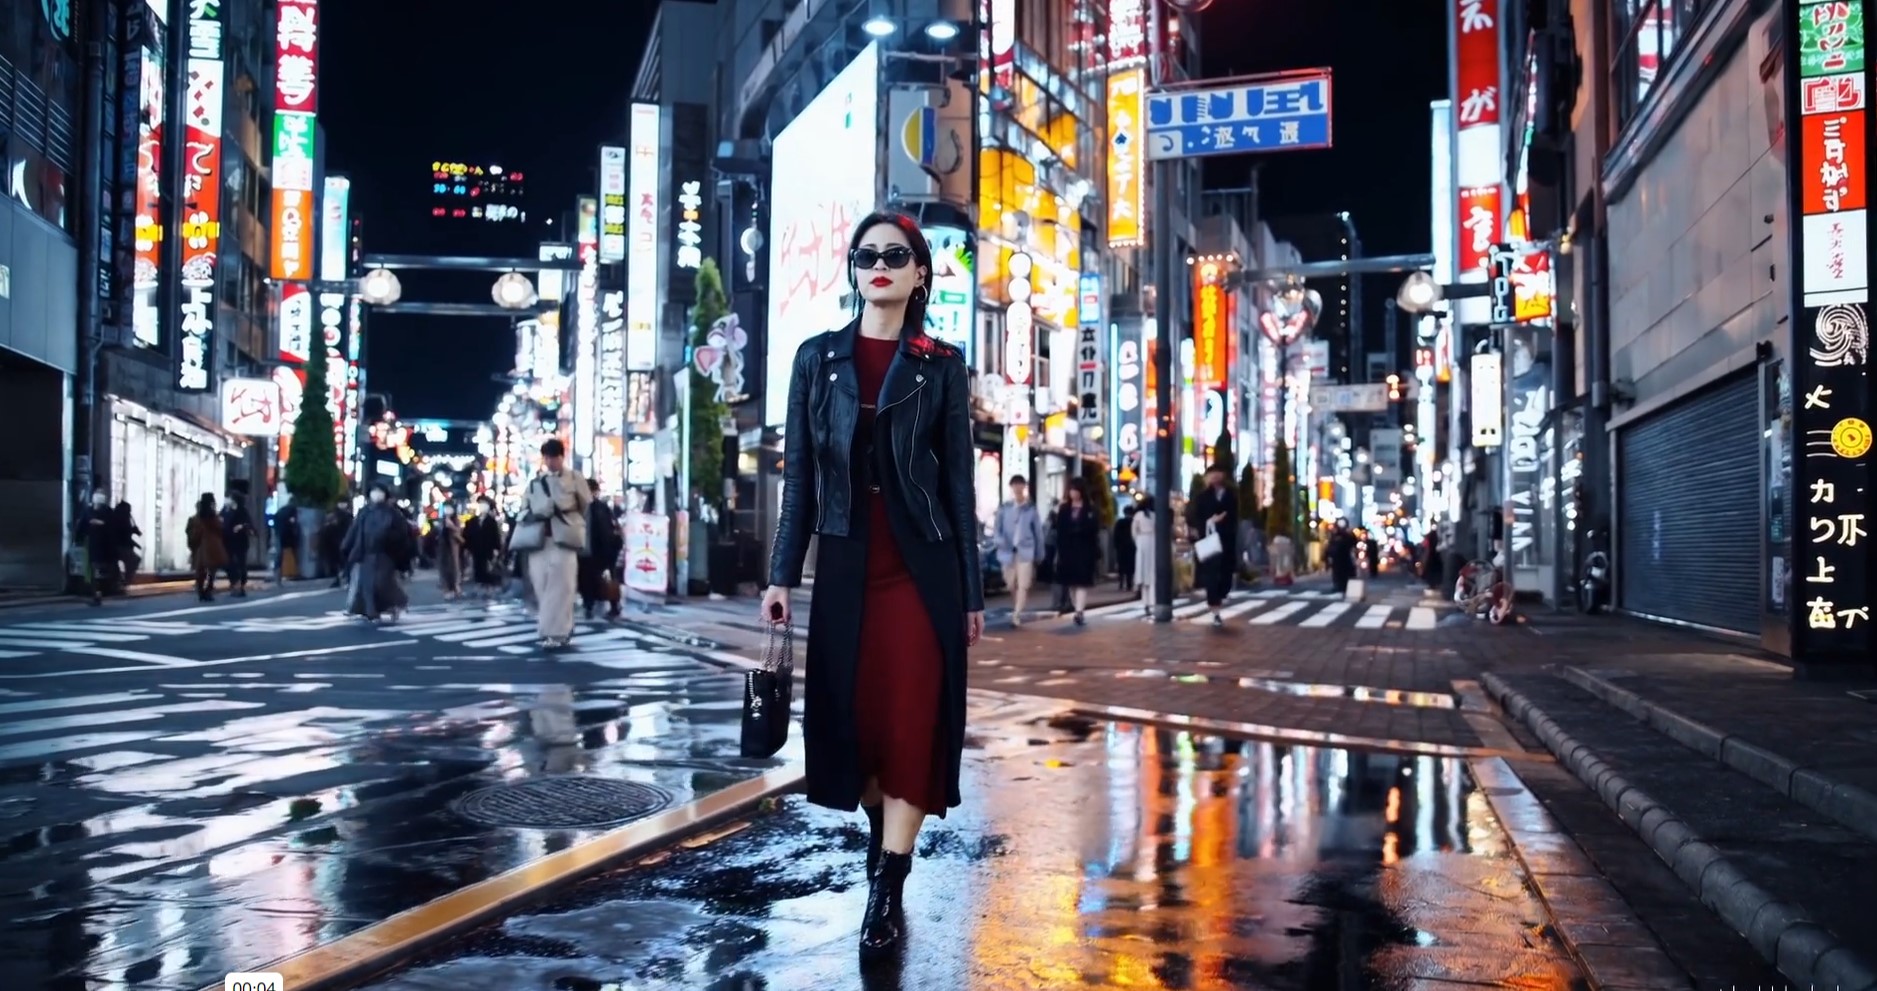
Sora是OpenAI开发的下一代AI视频生成模型,它能够将文本描述转化为高度逼真的视频画面,创造出既真实又充满想象力的场景。与传统AI视频工具(如Pika、Runway、Pixverse、Morph Studio、Genmo等)仅能生成数秒钟短视频的局限不同,Sora在视频时长上实现了质的飞跃——可生成长达一分钟的内容,同时在视觉质量、细节还原以及忠实呈现用户输入的文本描述上均表现出色。此外,Sora的应用形式也更为灵活:它不仅能从零开始生成完整视频,还支持基于静态图像生成动画,或是对现有视频进行扩展与补全。

Sora的核心功能
Sora的核心功能围绕「高效、高质量、多场景适配」设计,具体包括:
- 文本驱动的视频生成:基于用户提供的详细文本描述,生成涵盖场景、角色、动作、情感等多维度的匹配视频内容,支持创意内容的快速落地。
- 高视觉质量与忠实度:生成视频的视觉效果达到行业顶级水平,且严格遵循用户的文本提示,确保视频内容与描述高度一致,避免偏差。
- 物理世界模拟能力:模型能够模拟现实世界的运动规律与物理特性,让生成的视频更具真实感,可处理包含复杂角色动作的场景。
- 多角色与复杂场景处理:支持生成包含多个角色、复杂背景的视频内容,尽管在极端复杂场景下仍存在优化空间,但已远超多数同类工具的表现。
- 视频扩展与补全:除了从零创作,还可基于现有静态图像生成动画,或是对已有的视频片段进行延展,满足二次创作的多种需求。
Sora的核心技术基础
Sora的强大能力源于其扎实的技术架构,核心技术点包括:
- 文本条件生成:将文本信息与视频内容相结合,让模型准确理解用户描述,从而生成匹配的视频片段。
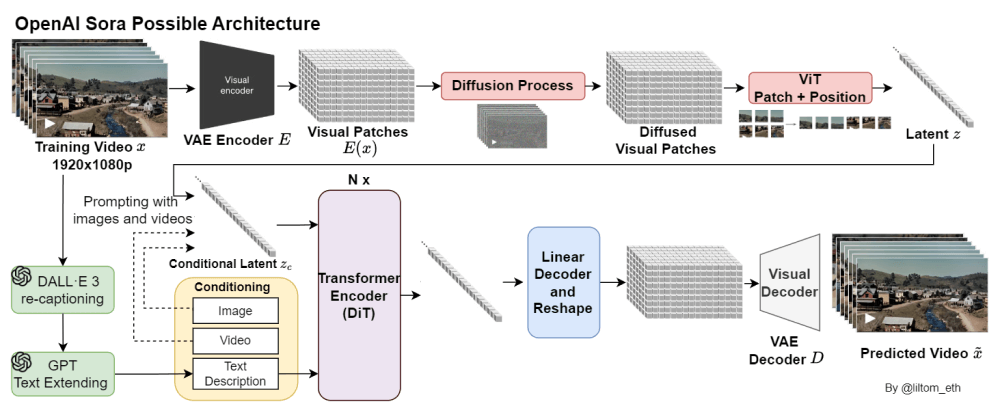
- 视觉块处理:把视频和图像拆解为低维度的小块视觉单元,既提升了复杂视觉信息的处理效率,又降低了计算负担。
- 视频压缩网络:在生成视频前,先将原始视频数据压缩到低维潜在空间,减少数据复杂度,便于模型学习与生成内容。
- 时空块处理:基于压缩后的视频表示,进一步分解为时空块作为输入,让模型能够精准理解视频的时间与空间特性。
- 扩散模型架构:采用基于Transformer的扩散模型作为核心生成机制,通过逐步去噪优化生成内容的质量。
- Transformer技术应用:利用Transformer架构的序列处理优势,高效处理视频中的时空序列数据,提升生成的连贯性。
- 大规模训练数据集:在海量视频数据集上训练,让模型学习到丰富的视觉模式与动态变化,保障生成内容的多样性与高质量。
- 文本到视频的指令转化:通过训练描述性字幕生成器,将用户的文本提示转化为细化的视频生成指令,确保输出与输入一致。
- 零样本学习能力:无需针对特定风格或类型的视频进行专门训练,即可通过文本提示生成匹配的创意内容。
- 现实物理规律模拟:训练中融入对3D一致性、物体持久性等物理特性的学习,使生成视频更贴近现实世界的物理逻辑。
想要深入了解Sora的技术细节,可参考以下权威资料:
Sora的主要应用场景
Sora的视频生成能力可覆盖多个领域,具体应用场景包括:
- 社交媒体短片制作:内容创作者无需掌握复杂的剪辑技能,即可通过文本描述快速生成符合平台风格的短视频,助力内容在社交媒体的高效传播。
- 广告营销创作:品牌可借助Sora快速生成视觉冲击力强的广告视频,且能低成本测试不同创意方向,优化营销策略。
- 设计原型与概念可视化:设计师、工程师可利用Sora生成建筑项目的3D动画、产品使用流程动画,帮助客户直观理解设计意图。
- 影视制作辅助:在影视前期阶段,Sora可快速生成故事板、特效预览,降低前期规划的成本,提升团队协作效率。
- 教育与培训内容制作:教育机构可通过Sora生成科学实验模拟视频、历史事件重现等内容,让复杂知识更直观易懂,提升学习效果。
目前如何使用Sora?
截至目前,**Sora尚未对公众开放使用**,仍处于严格的测试阶段。OpenAI正针对模型进行红队安全测试、功能优化与风险评估,仅向少数视觉艺术家、设计师、电影制作人等专业人士提供测试权限。OpenAI尚未公布面向大众开放的具体时间,但据推测可能在2024年内推出。若希望获取Sora的访问权限,申请者需符合OpenAI设定的专家标准,例如属于相关专业团体,以协助评估模型的实用性与风险缓解策略。